Arquitetura clássica de computador desktop com uma placa gráfica distinta sobre PCI Express. CPU e GPU têm memória física distinta, com espaços de endereço diferentes. Todos os dados precisam ser copiados pelo barramento PCIe. Observação: o diagrama mostra as larguras de banda, mas não a latência da memória.
 O GCN suporta "memória virtual unificada", permitindo, portanto, cópia zero. Em vez dos dados, apenas os ponteiros são copiados, "passados". Este é um recurso essencial do HSA.
 Soluções gráficas integradas (e APUs AMD com gráficos TeraScale) sofrem com a memória principal particionada: uma parte da memória do sistema é alocada exclusivamente à GPU. A cópia zero não é possível, os dados precisam ser copiados (pelo barramento de memória do sistema) de uma partição para a outra.
 As APUs AMD com gráficos GCN ganham com a memória principal unificada, conservando a escassa largura de banda.
Graphics Core Next
Graphics Core Next (GCN) é o codinome de uma série de microarquiteturas e uma arquitetura de conjunto de instruções que foram desenvolvidas pela AMD para suas GPUs como sucessoras de sua microarquitetura TeraScale. O primeiro produto com GCN foi lançado em 9 de janeiro de 2012.
GCN é uma microarquitetura SIMD de conjunto de instruções reduzido que contrasta com a arquitetura SIMD de Very Long Instruction Word do TeraScale. O GCN requer consideravelmente mais transístores que o TeraScale, mas oferece vantagens para computação de GPU de uso geral (GPGPU) devido a um compilador mais simples.
Os chips gráficos GCN foram fabricados com CMOS a 28 nm, e com FinFET em 14 nm (pela Samsung Electronics e GlobalFoundries) e 7 nm (pela TSMC), disponível em modelos selecionados nas séries de placas de vídeo Radeon HD 7000, HD 8000, 200, 300, 400, 500 e Vega da AMD, incluindo a Radeon VII lançada separadamente. O GCN também foi usado na parte gráfica das Unidades de Processamento Acelerado (APUs), incluindo aquelas no PlayStation 4 e no Xbox One.
O GCN foi sucedido pela microarquitetura RDNA e pela arquitetura do conjunto de instruções em 2019.
Conjunto de instruções
O conjunto de instruções GCN é de propriedade da AMD e foi desenvolvido especificamente para GPUs. Não possui micro-operação para divisão.
A documentação está disponível para:
- o conjunto de instruções do Graphics Core Next 1,
- o conjunto de instruções do Graphics Core Next 2,
- os conjuntos de instruções Graphics Core Next 3 e 4,
- o conjunto de instruções do Graphics Core Next 5 e
- arquitetura do conjunto de instruções "Vega" de 7 nm (também conhecida como Graphics Core Next 5.1).
Um backend do compilador LLVM está disponível para o conjunto de instruções GCN. É usado pelo Mesa 3D.
O GNU Compiler Collection 9 oferece suporte ao GCN 3 e ao GCN 5 desde 2019 para programas autônomos de thread única, com o GCC 10 também sendo descarregado via OpenMP e OpenACC.
MIAOW é uma implementação RTL de código aberto da microarquitetura AMD Southern Islands GPGPU.
Em novembro de 2015, a AMD anunciou sua Iniciativa Boltzmann, que visa permitir a portabilidade de aplicativos baseados em CUDA para um modelo de programação C++ comum.
No evento Super Computing 15, a AMD exibiu um Heterogeneous Compute Compiler (HCC), um driver Linux headless e uma infraestrutura de tempo de execução HSA para computação de alto desempenho em classe de cluster, e uma ferramenta Heterogeneous-compute Interface for Portability (HIP) para portar aplicativos CUDA para o modelo C++ comum mencionado anteriormente.
Microarquiteturas
Em julho de 2017, o conjunto de instruções do Graphics Core Next teve cinco iterações. As diferenças entre as quatro primeiras gerações são mínimas, mas a arquitetura GCN de quinta geração apresenta processadores de fluxo bastante modificados para melhorar o desempenho e suportar o processamento simultâneo de dois números de menor precisão no lugar de um único número de maior precisão.
Processamento de comando

Graphics Command Processor
O Processador de Comando Gráfico (Graphics Command Processor, GCP) é uma unidade funcional da microarquitetura GCN. Entre outras tarefas, é responsável pelo manuseio de shaders assíncronos.
Asynchronous Compute Engine
O Asynchronous Compute Engine (ACE) é um bloco funcional distinto que atende a propósitos de computação, cuja finalidade é semelhante à do Processador de Comando Gráfico.
Agendadores
Desde a terceira iteração do GCN, o hardware contém dois agendadores: um para agendar "frentes de onda" durante a execução do shader (o CU Scheduler ou Compute Unit Scheduler) e o outro para agendar a execução de filas de desenho e computação. Este último ajuda no desempenho executando operações de computação quando as unidades de computação (CUs) são subutilizadas devido a comandos gráficos limitados pela velocidade do pipeline de função fixa ou largura de banda. Essa funcionalidade é conhecida como Async Compute.
Para um determinado shader, os drivers da GPU também podem agendar instruções na CPU para minimizar a latência.
Geometric processor

O processador de geometria (Geometric processor) contém um Montador de Geometria, um Tesselador e um Montador de Vértices.
O Tesselator é capaz de fazer tesselação em hardware conforme definido pelo Direct3D 11 e OpenGL 4.5 (veja AMD 21 de janeiro de 2017), e sucedeu o ATI TruForm e a tesselação de hardware no TeraScale como o então mais recente núcleo de propriedade intelectual de semicondutores da AMD.
Compute units
Uma unidade de computação (Compute units, UC) combina 64 processadores de shader com 4 unidades de mapeamento de textura (TMUs). As unidades de computação são separadas, mas alimentam, as unidades de saída de renderização (ROPs). Cada unidade de computação consiste no seguinte:
- um CU scheduler
- uma Branch & Message Unit
- 4 SIMD Vector Units de 16 faixas de largura (SIMD-VUs)
- 4 arquivos de 64 KiB de registro de uso geral de vetores (VGPR)
- 1 scalar unit (SU)
- um arquivo GPR scalar de 8 KiB
- um compartilhamento de dados local de 64 KiB
- 4 Texture Filter Units
- 16 Texture Fetch Load/Store Units
- um Cache de 16 KiB de nível 1 (L1)
Quatro unidades de computação são conectadas para compartilhar um cache de instruções L1 de 16 KiB e um cache de dados L1 de 32 KiB, ambos somente leitura. Um SIMD-VU opera em 16 elementos por vez (por ciclo), enquanto um SU pode operar em um por vez (um/ciclo). Além disso, o SU lida com algumas outras operações, como ramificação.
Cada SIMD-VU tem alguma memória privada onde armazena seus registradores. Existem dois tipos de registradores: registradores escalares (S0, S1, etc.), que contêm números de 4 bytes cada, e registradores vetoriais (V0, V1, etc.), que representam cada um um conjunto de 64 números de 4 bytes. Nos registradores vetoriais, cada operação é feita em paralelo nos 64 números. que correspondem a 64 entradas. Por exemplo, ele pode funcionar em 64 pixels diferentes ao mesmo tempo (para cada um deles as entradas são ligeiramente diferentes e, portanto, você obtém uma cor ligeiramente diferente no final).
Cada SIMD-VU tem espaço para 512 registradores escalares e 256 registradores vetoriais.
A AMD afirmou que cada unidade de computação GCN (CU) tem 64 KiB de compartilhamento de dados local (LDS).
CU scheduler
O agendador CU (CU scheduler) é o bloco funcional de hardware, que escolhe quais frentes de onda o SIMD-VU executa. Ele escolhe um SIMD-VU por ciclo para agendamento. Não deve ser confundido com outros agendadores de hardware ou software.
Wavefront
Um shader é um pequeno programa escrito em GLSL que executa processamento gráfico, e um kernel é um pequeno programa escrito em OpenCL que executa processamento GPGPU. Esses processos não precisam de tantos registradores, mas precisam carregar dados da memória do sistema ou gráfica. Esta operação vem com latência significativa. A AMD e a Nvidia escolheram abordagens semelhantes para esconder essa latência inevitável: o agrupamento de vários threads. A AMD chama esse grupo de "wavefront", enquanto a Nvidia o chama de "warp". Um grupo de threads é a unidade mais básica de agendamento de GPUs que implementam essa abordagem para ocultar a latência. É o tamanho mínimo dos dados processados no modo SIMD, a menor unidade executável de código e a maneira de processar uma única instrução em todos os threads ao mesmo tempo.
Em todas as GPUs GCN, uma "wavefront" consiste em 64 threads, e em todas as GPUs Nvidia, uma "warp" consiste em 32 threads.
A solução da AMD é atribuir múltiplas frentes de onda a cada SIMD-VU. O hardware distribui os registradores para as diferentes frentes de onda e, quando uma frente de onda está esperando por algum resultado, que está na memória, o CU Scheduler atribui outra frente de onda ao SIMD-VU. As frentes de onda são atribuídas por SIMD-VU. SIMD-VUs não trocam frentes de onda. Um máximo de 10 frentes de onda podem ser atribuídas por SIMD-VU (portanto, 40 por CU).
O AMD CodeXL mostra tabelas com a relação entre o número de SGPRs e VGPRs em relação ao número de frentes de onda, mas essencialmente, para SGPRS é entre 104 e 512 por número de frentes de onda, e para VGPRS é 256 por número de frentes de onda.
Observe que, em conjunto com as instruções SSE, esse conceito do nível mais básico de paralelismo é frequentemente chamado de "largura de vetor". A largura do vetor é caracterizada pelo número total de bits nele contidos.
SIMD Vector Unit
Cada Unidade Vetorial SIMD (SIMD Vector Unit) possui:
- uma Unidade Lógica Aritmética (Arithmetic Logic Unit, ALU) de 16 pistas, com vetores inteiros e de ponto flutuante
- 64 Arquivo KiB Vector General Purpose Register (VGPR)
- 10× Contadores de Programa (Program Counters) de 48 bits
- Buffer de instruções para 10 wavefronts (cada wavefront é um grupo de 64 threads, ou o tamanho de um VGPR lógico)
- Uma wavefront de 64 threads emite para uma SIMD Unit de 16 pistas ao longo de quatro ciclos
Cada SIMD-VU tem 10 buffers de instruções de wavefront e leva 4 ciclos para executar uma wavefront.
Blocos de aceleração de áudio e vídeo
Muitas implementações do GCN são normalmente acompanhadas por vários outros blocos ASIC da AMD. Incluindo, mas não se limitando ao Unified Video Decoder, Video Coding Engine e AMD TrueAudio.
Video Coding Engine
O Video Coding Engine é um ASIC de codificação de vídeo, introduzido pela primeira vez com a série Radeon HD 7000.
A versão inicial do VCE adicionou suporte para codificação de quadros I e P H.264 no formato de pixel YUV420, juntamente com codificação temporal SVE e modo de codificação de exibição, enquanto a segunda versão adicionou suporte de quadro B para quadros I YUV420 e YUV444.
O VCE 3.0 fez parte da terceira geração do GCN, adicionando dimensionamento de vídeo de alta qualidade e o codec HEVC (H.265).
O VCE 4.0 fazia parte da arquitetura Vega e foi posteriormente sucedido pelo Video Core Next.
Unified virtual memory
Em uma prévia em 2011, AnandTech escreveu sobre a memória virtual unificada (Unified virtual memory), suportada pelo Graphics Core Next.


Heterogeneous System Architecture (HSA)

Alguns dos recursos específicos do HSA implementados no hardware precisam de suporte do kernel do sistema operacional (seus subsistemas) e/ou de drivers de dispositivo específicos. Por exemplo, em julho de 2014, a AMD publicou um conjunto de 83 patches a serem incorporados ao kernel Linux mainline 3.17 para oferecer suporte às suas placas de vídeo Radeon baseadas no Graphics Core Next. O chamado driver de kernel HSA reside no diretório /drivers/gpu/hsa, enquanto os drivers de dispositivos gráficos DRM residem em /drivers/gpu/drm e aumentar os drivers DRM já existentes para placas Radeon. Esta primeira implementação se concentra em uma única APU "Kaveri" e funciona junto com o driver gráfico do kernel Radeon existente (kgd).
Agendadores de hardware
Os agendadores de hardware são usados para executar o agendamento e descarregar a atribuição de filas de computação aos ACEs do driver para o hardware, armazenando essas filas em buffer até que haja pelo menos uma fila vazia em pelo menos um ACE. Isso faz com que o HWS atribua imediatamente filas armazenadas em buffer aos ACEs até que todas as filas estejam cheias ou não haja mais filas para atribuir com segurança.
Parte do trabalho de agendamento realizado inclui filas priorizadas que permitem que tarefas críticas sejam executadas com prioridade mais alta do que outras tarefas sem exigir que as tarefas de prioridade mais baixa sejam preemptivas para executar a tarefa de alta prioridade, permitindo assim que as tarefas sejam executadas simultaneamente com as tarefas de alta prioridade agendadas para monopolizar a GPU o máximo possível, enquanto permite que outras tarefas usem os recursos que as tarefas de alta prioridade não estão usando. Esses são essencialmente mecanismos de computação assíncronos que não possuem controladores de despacho. Eles foram introduzidos pela primeira vez na microarquitetura GCN de quarta geração, mas estavam presentes na microarquitetura GCN de terceira geração para fins de testes internos. Uma atualização de driver habilitou os planejadores de hardware em peças GCN de terceira geração para uso em produção.
Acelerador de Descarte Primitivo
Esta unidade descarta triângulos degenerados antes de entrarem no shader de vértice e triângulos que não cobrem nenhum fragmento antes de entrarem no shader de fragmento. Esta unidade foi introduzida com a microarquitetura GCN de quarta geração.
Gerações
Graphics Core Next 1
Graphics Core Next | |
|---|---|
| Nome | |
| AMD Graphics Core Next 1 | |
| Data de lançamento | |
| Janeiro de 2012 | |
| História | |
| Antecessor | |
| TeraScale 3 | |
| Sucessor | |
| Graphics Core Next 2 | |
| Status de suporte | |
| Sem suporte desde meados de 2022 (versão final do driver do Windows 22.6.1 para Windows 7 e 10) |
A microarquitetura GCN 1 foi usada em várias placas de vídeo da série Radeon HD 7000.

- suporte para endereçamento de 64 bits (espaço de endereço x86-64) com espaço de endereço unificado para CPU e GPU
- suporte para PCIe 3.0
- A GPU envia solicitações de interrupção à CPU em vários eventos (como falhas de página)
- suporte para texturas parcialmente residentes, que permitem suporte de memória virtual por meio de extensões DirectX e OpenGL
- Suporte AMD PowerTune, que ajusta dinamicamente o desempenho para permanecer dentro de um TDP específico
- suporte para Mantle (API)
Existem mecanismos de computação assíncronos que controlam a computação e o despacho.
ZeroCore Power
ZeroCore Power é uma tecnologia de economia de energia em modo ocioso longo, desligando unidades funcionais da GPU quando não estão em uso. A tecnologia AMD ZeroCore Power complementa o AMD PowerTune.
Chips
GPUs discretas (família Southern Islands):
- Hainan
- Oland
- Cape Verde
- Pitcairn
- Tahiti
Graphics Core Next 2
Graphics Core Next | |
|---|---|
| Nome | |
| AMD Graphics Core Next 2 | |
| Data de lançamento | |
| Setembro de 2013 | |
| História | |
| Antecessor | |
| Graphics Core Next 1 | |
| Sucessor | |
| Graphics Core Next 3 | |
| Status de suporte | |
| Sem suporte desde meados de 2022 (versão final do driver do Windows 22.6.1 para Windows 7 e 10) |


A segunda geração do GCN foi introduzida com a Radeon HD 7790 e também é encontrada nas Radeon HD 8770, R7 260/260X, R9 290/290X, R9 295X2, R7 360 e R9 390/390X, bem como nas APUs de desktop "Kaveri" baseadas em Steamroller e nas APUs móveis "Kaveri" baseadas em Puma e nas APUs "Beema" e "Mullins". Ele tem várias vantagens sobre o GCN original, incluindo suporte a FreeSync, AMD TrueAudio e uma versão revisada da tecnologia AMD PowerTune.
A segunda geração do GCN introduziu uma entidade chamada "Shader Engine" (SE). Um Shader Engine compreende um processador de geometria, até 44 CUs (chip Hawaii), rasterizadores, ROPs e cache L1. Não fazem parte de um Shader Engine o Graphics Command Processor, os 8 ACEs, o cache L2 e os controladores de memória, bem como os aceleradores de áudio e vídeo, os controladores de vídeo, os 2 controladores DMA e a interface PCIe.
O A10-7850K "Kaveri" contém 8 CUs (unidades de computação) e 8 mecanismos de computação assíncronos para agendamento independente e despacho de itens de trabalho.
No AMD Developer Summit (APU) em novembro de 2013, Michael Mantor apresentou a Radeon R9 290X.
Chips
GPUs discretas (família Sea Islands):
- Bonaire
- Hawaii
integrados em APUs:
- Temash
- Kabini
- Liverpool (ou seja, a APU encontrada no PlayStation 4)
- Durango (ou seja, a APU encontrada no Xbox One e no Xbox One S)
- Kaveri
- Godavari
- Mullins
- Beema
- Carrizo-L
Graphics Core Next 3
Graphics Core Next | |
|---|---|
| Nome | |
| AMD Graphics Core Next 3 | |
| Data de lançemanto | |
| junho de 2015 | |
| História | |
| Antecessor | |
| Graphics Core Next 2 | |
| Sucessor | |
| Graphics Core Next 4 | |
| Status de suporte | |
| Suportado, com cronograma de atualização de driver do Windows menos regular |

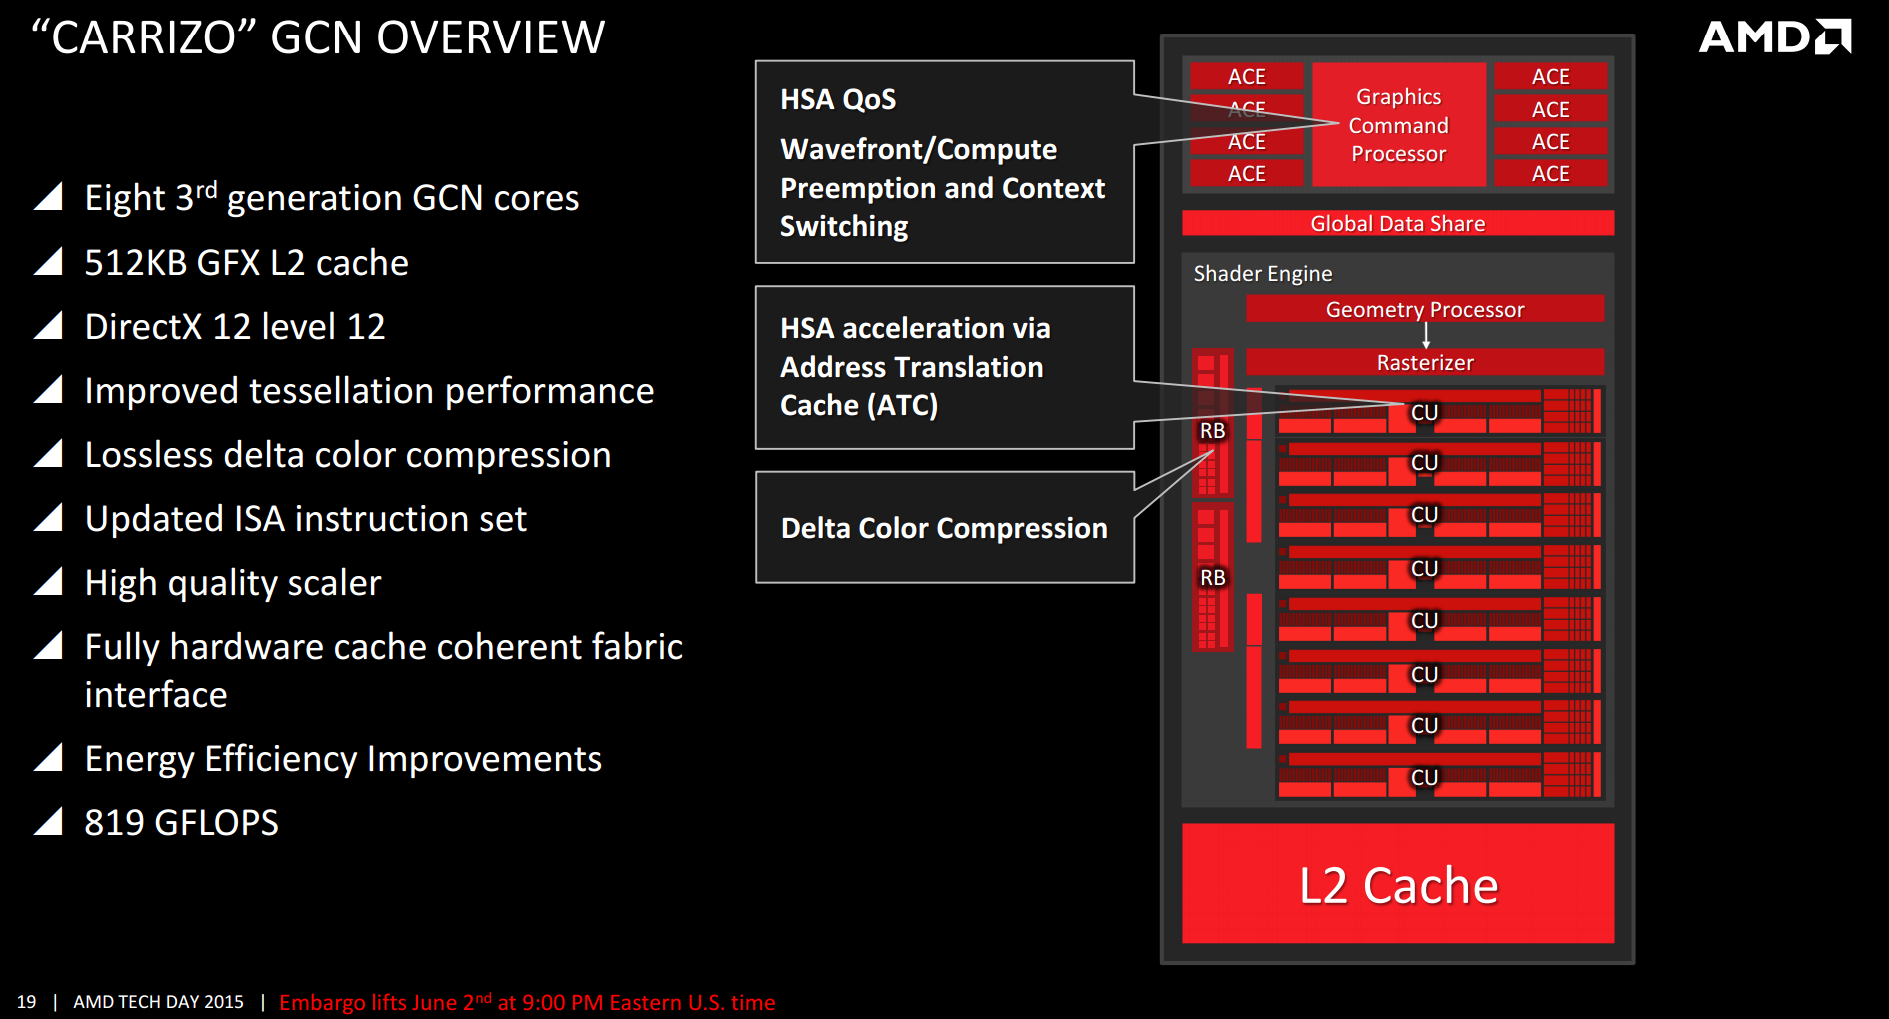
A 3ª geração do GCN foi introduzida em 2014 com as Radeon R9 285 e R9 M295X, que possuem a GPU "Tonga". Ele apresenta desempenho de tesselação aprimorado, compressão de cor delta sem perdas para reduzir o uso de largura de banda da memória, um conjunto de instruções atualizado e mais eficiente, um novo escalonador de alta qualidade para vídeo, codificação HEVC (VCE 3.0) e decodificação HEVC (UVD 6.0) e um novo mecanismo de multimídia (codificador/decodificador de vídeo). A compressão de cores Delta é suportada no Mesa. No entanto, seu desempenho de dupla precisão é pior em comparação à geração anterior.
Chips
GPUs discretas:
- Tonga (família Volcanic Islands), vem com UVD 5.0 (Unified Video Decoder)
- Fiji (família Pirate Islands), vem com UVD 6.0 e memória de alta largura de banda (High Bandwidth Memory, HBM 1)
integrados em APUs:
- Carrizo, vem com UVD 6.0
- Bristol Ridge
- Stoney Ridge
Graphics Core Next 4
Graphics Core Next | |
|---|---|
| Nome | |
| AMD Graphics Core Next 4 | |
| Data de lançemanto | |
| junho de 2016 | |
| História | |
| Antecessor | |
| Graphics Core Next 3 | |
| Sucessor | |
| Graphics Core Next 5 | |
| Status de suporte | |
| Suportado, com cronograma de atualização de driver do Windows menos regular |


As GPUs da família Arctic Islands foram introduzidas no segundo trimestre de 2016 com a série AMD Radeon 400. O motor 3D (ou seja, GCA (Graphics and Compute array) ou GFX) é idêntico ao encontrado nos chips Tonga. Mas o Polaris conta com um mecanismo de controle de exibição mais recente, UVD versão 6.3, etc.
Todos os chips baseados em Polaris, exceto o Polaris 30, são produzidos no processo FinFET de 14 nm, desenvolvido pela Samsung Electronics e licenciado para a GlobalFoundries. O Polaris 30, um pouco mais novo e atualizado, é construído no nó de processo LP FinFET de 12 nm, desenvolvido pela Samsung e pela GlobalFoundries. A arquitetura do conjunto de instruções GCN de quarta geração é compatível com a terceira geração. É uma otimização para processo de 14 nm FinFET permitindo velocidades de clock de GPU mais altas do que com a 3ª geração GCN. As melhorias arquitetônicas incluem novos agendadores de hardware, um novo acelerador de descarte primitivo, um novo controlador de exibição e um UVD atualizado que pode decodificar HEVC em resoluções 4K a 60 quadros por segundo com 10 bits por canal de cor.
Chips
GPUs discretas:
- Polaris 10 (também conhecido como Ellesmere) encontrado em placas de vídeo das marcas "Radeon RX 470" e "Radeon RX 480"
- Polaris 11 (também conhecido como Baffin) encontrado em placas de vídeo da marca "Radeon RX 460" (também Radeon RX 560 D)
- Polaris 12 (também conhecido como Lexa) encontrado em placas de vídeo das marcas "Radeon RX 550" e "Radeon RX 540"
- Polaris 20, que é um Polaris 10 atualizado (processo LPP Samsung / GloFo FinFET de 14 nm) com relógios mais altos, usado para placas gráficas das marcas "Radeon RX 570" e "Radeon RX 580"
- Polaris 21, que é uma versão atualizada (14 nm LPP Samsung/GloFo FinFET) Polaris 11, usado para placas de vídeo da marca "Radeon RX 560"
- Polaris 22, encontrado em placas de vídeo das marcas "Radeon RX Vega M GH" e "Radeon RX Vega M GL" (como parte do Kaby Lake-G)
- Polaris 23, que é uma versão atualizada (14 nm LPP Samsung/GloFo FinFET) Polaris 12, usado para placas gráficas das marcas "Radeon Pro WX 3200" e "Radeon RX 540X" (também Radeon RX 640)
- Polaris 30, que é um Polaris 20 atualizado (processo LP GloFo FinFET de 12 nm) com clocks mais altos, usado para placas de vídeo da marca "Radeon RX 590"
Além das GPUs dedicadas, o Polaris é utilizado nas APUs do PlayStation 4 Pro e do Xbox One X, intituladas "Neo" e "Scorpio", respectivamente.
Precision Performance
O desempenho FP64 de todas as GPUs GCN de 4ª geração é 1/16 do desempenho FP32.
Graphics Core Next 5
Graphics Core Next | |
|---|---|
| Nome | |
| AMD Graphics Core Next 5 | |
| Data de lançemanto | |
| junho de 2017 | |
| História | |
| Antecessor | |
| Graphics Core Next 4 | |
| Sucessor | |
| RDNA 1 | |
| Status de suporte | |
| Suportado, com cronograma de atualização de driver do Windows menos regular |

A AMD começou a divulgar detalhes de sua próxima geração de arquitetura GCN, denominada 'Next-Generation Compute Unit', em janeiro de 2017. Esperava-se que o novo design aumentasse o número de instruções por clock, maiores velocidades de clock, suporte para HBM2 e um maior espaço de endereço de memória. Os chipsets gráficos discretos também incluem "HBCC (High Bandwidth Cache Controller)", mas não quando integrados em APUs. Além disso, esperava-se que os novos chips incluíssem melhorias nas unidades de saída de rasterização e renderização. Os processadores de fluxo foram bastante modificados em relação às gerações anteriores para oferecer suporte à tecnologia matemática compactada Rapid Pack Math para números de 8, 16 e 32 bits. Com isso, há uma vantagem significativa de desempenho quando uma precisão menor é aceitável (por exemplo: processar dois números de meia precisão na mesma taxa de um único número de precisão simples).
A Nvidia introduziu a rasterização baseada em blocos e a binning com o Maxwell, e esta foi uma grande razão para o aumento da eficiência do Maxwell. Em janeiro, AnandTech assumiu que a Vega finalmente alcançaria a Nvidia em relação às otimizações de eficiência energética devido ao novo "DSBR (Draw Stream Binning Rasterizer)" a ser introduzido com a Vega.
Ele também adicionou suporte para um novo estágio de shader – Primitive Shaders. Os shaders primitivos fornecem processamento de geometria mais flexível e substituem os shaders de vértice e geometria em um pipeline de renderização. A partir de dezembro de 2018, os shaders primitivos não podem ser usados porque as alterações necessárias na API ainda não foram feitas.
Vega 10 e Vega 12 usam o processo 14 nm FinFET, desenvolvido pela Samsung Electronics e licenciado para a GlobalFoundries. Vega 20 usa o processo 7 nm FinFET desenvolvido pela TSMC.
Chips
GPUs discretas:
- Vega 10 (14 nm Samsung / GloFo FinFET) (também conhecido como Greenland) encontrado nas placas de vídeo "Radeon RX Vega 64", "Radeon RX Vega 56", "Radeon Vega Frontier Edition", "Radeon Pro V340", Radeon Pro WX 9100 e Radeon Pro WX 8200
- Vega 12 (14 nm (processo Samsung/GloFo FinFET) encontrado em placas gráficas móveis das marcas "Radeon Pro Vega 20" e "Radeon Pro Vega 16"
- Vega 20 (7 nm processo TSMC FinFET) encontrado em placas aceleradoras das marcas "Radeon Instinct MI50" e "Radeon Instinct MI60", placas gráficas das marcas "Radeon Pro Vega II" e "Radeon VII".
integrados em APUs:
- Raven Ridge veio com VCN 1 que substitui VCE e UVD e permite decodificação VP9 de função fixa completa.
- Picasso
- Renoir
- Cezanne
Precision performance
O desempenho de ponto flutuante de precisão dupla (FP64) de todas as GPUs GCN de 5ª geração, exceto a Vega 20, é um dezesseis avos do desempenho do FP32. Para Vega 20 com Radeon Instinct, isso é metade do desempenho do FP32. Para Vega 20 com Radeon VII, isso é um quarto do desempenho do FP32. Todas as GPUs GCN de 5ª geração suportam cálculos de ponto flutuante de meia precisão (FP16), o que é o dobro do desempenho do FP32.
Comparação de GPUs GCN
- A tabela contém apenas GPUs discretas (incluindo móveis). APU(IGP) e SoCs de console não estão listados.
| Microarquitetura | GCN 1 | GCN 2 | GCN 3 | GCN 4 | GCN 5 | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Die | Tahiti | Pitcairn | Cape Verde | Oland | Hainan | Bonaire | Hawaii | Topaz | Tonga | Fiji | Ellesmere | Baffin | Lexa | Vega 10 | Vega 12 | Vega 20 | |
| Codinome1 | ? | ? | ? | Tiran | ? | ? | Ibiza | Iceland | ? | ? | Polaris 10 | Polaris 11 | Polaris 12 | Greenland | Treasure Refresh | Moonshot | |
| Variante(s) | New Zealand Malta |
Wimbledon Curaçao Neptune Trinidad |
Chelsea Heathrow Venus Tropo |
Mars Opal Litho |
Sun Jet Exo Banks |
Saturn Tobago Strato Emerald |
Vesuvius Grenada |
Meso Weston Polaris 24 |
Amethyst Antigua |
Capsaicin | Polaris 20 Polaris 30 |
Polaris 21 | Polaris 23 | — | — | — | |
| Fab | TSMC 28 nm | GlobalFoundries 14 nm / 12 nm (Polaris 30) | TSMC 7 nm | ||||||||||||||
| Tamanho do di (mm2) | 352 / 365 (Malta) | 212 | 123 | 77 | 56 | 160 | 438 | 125 | 366 | 596 | 232 | 123 | 103 | 495 | Desconhecido | 331 | |
| Transistores (milhões) | 4,313 | 2,800 | 1,500 | 950 | 690 | 2,080 | 6,200 | 1,550 | 5,000 | 8,900 | 5,700 | 3,000 | 2,200 | 12,500 | Desconhecido | 13,230 | |
| Densidade do transistor (MTr/mm2) | 12.3 / 12.8 (Malta) | 13.2 | 12.2 | 12.3 | 13.0 | 14.2 | 12.4 | 13.7 | 14.9 | 24.6 | 24.4 | 21.4 | 25.3 | Desconhecido | 40.0 | ||
| Motores de computação assíncronos | 2 | 8 | ? | 8 | 4 | ? | 4 | ||||||||||
| Geometry engines | 2 | 1 | 2 | — | ? | — | 4 | ? | 4 | ||||||||
| Motores de shader | — | 4 | ? | 4 | 2 | — | |||||||||||
| Agendadores de hardware | — | 2 | ? | 2 | |||||||||||||
| Compute units | 32 | 20 | 10 / 8 (Chelsea) | 6 | 5 / 6 (Jet) | 14 | 44 | 6 | 32 | 64 | 36 | 16 | 10 | 64 | 20 | 64 | |
| Stream processors | 2048 | 1280 | 640 / 512 (Chelsea) | 384 | 320 / 384 (Jet) | 896 | 2816 | 384 | 2048 | 4096 | 2304 | 1024 | 640 | 4096 | 1280 | 4096 | |
| Unidades de mapeamento de textura | 128 | 80 | 40 / 32 (Chelsea) | 24 | 20 / 24 (Jet) | 56 | 176 | 24 | 128 | 256 | 144 | 64 | 40 | 256 | 80 | 256 | |
| Unidades de saída de renderização | 32 | 16 | 8 | 16 | 64 | 8 | 32 | 64 | 32 | 16 | 64 | 32 | 64 | ||||
| Z/Stencil OPS | 128 | 64 | 16 | 64 | 256 | 16 | 128 | 256 | — | ||||||||
| cache L1 (KB) | 16 por Compute unit (CU) | ||||||||||||||||
| cache L2 (KB) | 768 | 512 | 256 | 128 / 256 (Jet) | 256 | 1024 | 256 | 768 | 2048 | 1024 | 512 | 4096 | 1024 | 4096 | |||
| Motor de núcleo de exibição | 6.0 | 6.4 | — | 8.2 | 8.5 | — | 10.0 | 11.2 | 12.0 | 12.1 | |||||||
| Unified Video Decoder | 3.2 | 4.0 | — | 4.2 | — | 5.0 | 6.0 | 6.3 | 7.0 | 7.2 | |||||||
| Video Coding Engine | 1.0 | — | 2.0 | — | 3.0 | 3.4 | 4.0 | 4.1 | |||||||||
| Lançamento2 | Dezembro de 2011 | Março de 2012 | Fevereiro de 2012 | Janeiro de 2013 | Maio de 2015 | Março de 2013 | Outubro de 2013 | 2014 | Agosto de 2014 | Junho de 2015 | Junho de 2016 | Agosto de 2016 | Abril de 2017 | Junho de 2017 | Novembro de 2018 | Novembro de 2018 | |
| Série (Família) | Southern Islands | Sea Islands | Volcanic Islands | Pirate Islands | Arctic Islands | Vega | Vega II | ||||||||||
| Notas | mobile/OEM | mobile/OEM | mobile | ||||||||||||||
1 Nomes de código antigos como Treasure (Lexa) ou Hawaii Refresh (Ellesmere) não estão listados. 2 Data de lançamento inicial. As datas de lançamento de chips variantes como o Polaris 20 (abril de 2017) não estão listadas.
Ver também
Referências
- ↑ «AMD Launches World's Fastest Single-GPU Graphics Card – the AMD Radeon HD 7970» (Nota de imprensa). AMD. 22 de dezembro de 2011. Consultado em 24 de abril de 2025. Cópia arquivada em 20 de janeiro de 2015
- ↑ Gulati, Abheek (11 de novembro de 2019). «An Architectural Deep-Dive into AMD's TeraScale, GCN & RDNA GPU Architectures». Medium (em inglês). Consultado em 24 de abril de 2025
- ↑ «AMD community forums». Community.amd.com. 15 de julho de 2016. Cópia arquivada em 13 de janeiro de 2017
- ↑ «LLVM back-end amdgpu». Llvm.org
- ↑ «GCC 9 Release Series Changes, New Features, and Fixes». Consultado em 24 de abril de 2025
- ↑ «AMD GCN Offloading Support». Consultado em 24 de abril de 2025
- ↑ «AMD Boltzmann Initiative – Heterogeneous-compute Interface for Portability (HIP)». 16 de novembro de 2015. Consultado em 24 de abril de 2025. Arquivado do original em 26 de janeiro de 2016
- ↑ Smith, Ryan (5 de janeiro de 2017). «The AMD Vega GPU Architecture Preview». Anandtech.com. Consultado em 24 de abril de 2025
- ↑ Smith, Ryan. «AMD Dives Deep On Asynchronous Shading». Anandtech.com
- ↑ «Conformant Products». Khronos.org. 26 de outubro de 2017
- ↑ Compute Cores Whitepaper (PDF). [S.l.]: AMD. 2014. Cópia arquivada (PDF) em 29 de março de 2017
- 1 2 Smith, Ryan (21 de dezembro de 2011). «AMD's Graphics Core Next Preview». Anandtech.com. Consultado em 24 de abril de 2025
- ↑ «AMD's Graphics Core Next (GCN) Architecture» (PDF). TechPowerUp. Consultado em 24 de abril de 2025
- 1 2 Mantor, Michael; Houston, Mike (15 de junho de 2011). «AMD Graphics Core Next» (PDF). AMD. p. 40. Consultado em 24 de abril de 2025. Cópia arquivada (PDF) em 19 de maio de 2014
- ↑ «Optimizing GPU occupancy and resource usage with large thread groups». AMD GPUOpen (em inglês). Consultado em 24 de abril de 2025
- ↑ «White Paper AMD UnifiedVideoDecoder (UVD)» (PDF). 15 de junho de 2012. Consultado em 24 de abril de 2025. Cópia arquivada (PDF) em 1 de maio de 2014
- 1 2 «Not Just A New Architecture, But New Features Too». AnandTech. 21 de dezembro de 2011. Consultado em 24 de abril de 2025
- ↑ «Kaveri microarchitecture». SemiAccurate. 15 de janeiro de 2014
- ↑ Airlie, Dave (26 de novembro de 2014). «Merge AMDKFD». freedesktop.org. Consultado em 24 de abril de 2025. Cópia arquivada em 25 de dezembro de 2018
- ↑ «/drivers/gpu/drm». Kernel.org
- ↑ «[PATCH 00/83] AMD HSA kernel driver». LKML. 10 de julho de 2014. Consultado em 24 de abril de 2025
- 1 2 3 4 5 Angelini, Chris (29 de junho de 2016). «AMD Radeon RX 480 8GB Review». Tom's Hardware. p. 1. Consultado em 24 de abril de 2025
- ↑ «Dissecting the Polaris Architecture» (PDF). 2016. Consultado em 24 de abril de 2025. Cópia arquivada (PDF) em 20 de setembro de 2016
- ↑ Shrout, Ryan (29 de junho de 2016). «The AMD Radeon RX 480 Review – The Polaris Promise». PC Perspective. p. 2. Consultado em 24 de abril de 2025. Cópia arquivada em 10 de outubro de 2016
- 1 2 Smith, Ryan (29 de junho de 2016). «The AMD Radeon RX 480 Preview: Polaris Makes Its Mainstream Mark». AnandTech. p. 3. Consultado em 24 de abril de 2025
- ↑ «AMD Radeon HD 7000 Series to be PCI-Express 3.0 Compliant». TechPowerUp. Consultado em 24 de abril de 2025
- ↑ «AMD Details Next Gen. GPU Architecture». Consultado em 24 de abril de 2025. Arquivado do original em 28 de março de 2012
- ↑ Tony Chen; Jason Greaves. «AMD's Graphics Core Next (GCN) Architecture» (PDF). AMD. Consultado em 24 de abril de 2025. Cópia arquivada (PDF) em 18 de janeiro de 2023
- ↑ «AMD's Graphics Core Next Preview: AMD's New GPU, Architected For Compute». AnandTech. 21 de dezembro de 2011. Consultado em 24 de abril de 2025
- ↑ «Managing Idle Power: Introducing ZeroCore Power». AnandTech.com. 22 de dezembro de 2011. Consultado em 24 de abril de 2025
- ↑ «AMD's Kaveri A10-7850K tested». AnandTech. 14 de janeiro de 2014. Consultado em 24 de abril de 2025
- ↑ «Carrizo Overview» (PNG). Images.anandtech.com. Consultado em 24 de abril de 2025
- ↑ «Add DCC Support». Freedesktop.org. 11 de outubro de 2015
- ↑ Smith, Ryan (10 de setembro de 2014). «AMD Radeon R9 285 Review». Anandtech.com. Consultado em 24 de abril de 2025
- 1 2 Cutress, Ian (1 de junho de 2016). «AMD Announces 7th Generation APU». Anandtech.com. Consultado em 24 de abril de 2025
- ↑ «RadeonFeature». www.x.org
- ↑ «Radeon Technologies Group – January 2016 – AMD Polaris Architecture». Guru3d.com
- 1 2 Smith, Ryan (5 de janeiro de 2017). «The AMD Vega Architecture Teaser: Higher IPC, Tiling, & More, coming in H1'2017». Anandtech.com. Consultado em 24 de abril de 2025
- ↑ WhyCry (24 de março de 2016). «AMD confirms Polaris 10 is Ellesmere and Polaris 11 is Baffin». VideoCardz. Consultado em 24 de abril de 2025
- ↑ «Fast vollständige Hardware-Daten zu AMDs Radeon RX 500 Serie geleakt». www.3dcenter.org. Consultado em 24 de abril de 2025
- ↑ «AMD Polaris 23». TechPowerUp. Consultado em 24 de abril de 2025
- ↑ Oh, Nate (15 de novembro de 2018). «The AMD Radeon RX 590 Review, feat. XFX & PowerColor: Polaris Returns (Again)». anandtech.com. Consultado em 24 de abril de 2025
- ↑ Kampman, Jeff (5 de janeiro de 2017). «The curtain comes up on AMD's Vega architecture». TechReport.com. Consultado em 24 de abril de 2025. Cópia arquivada em 6 de janeiro de 2017
- ↑ Shrout, Ryan (5 de janeiro de 2017). «AMD Vega GPU Architecture Preview: Redesigned Memory Architecture». PC Perspective. Consultado em 24 de abril de 2025
- ↑ Kampman, Jeff (26 de outubro de 2017). «AMD's Ryzen 7 2700U and Ryzen 5 2500U APUs revealed». Techreport.com. Consultado em 24 de abril de 2025. Cópia arquivada em 1 de novembro de 2017
- ↑ Raevenlord (1 de março de 2017). «On NVIDIA's Tile-Based Rendering». techPowerUp
- ↑ «Vega Teaser: Draw Stream Binning Rasterizer». Anandtech.com
- ↑ «Radeon RX Vega Revealed: AMD promises 4K gaming performance for $499 – Trusted Reviews». Trustedreviews.com. 31 de julho de 2017. Consultado em 24 de abril de 2025. Arquivado do original em 14 de julho de 2017
- ↑ «The curtain comes up on AMD's Vega architecture». Techreport.com. Consultado em 24 de abril de 2025. Arquivado do original em 1 de setembro de 2017
- ↑ Kampman, Jeff (23 de janeiro de 2018). «Radeon RX Vega primitive shaders will need API support». Techreport.com. Consultado em 24 de abril de 2025. Cópia arquivada em 24 de janeiro de 2018
- ↑ «ROCm-OpenCL-Runtime/libUtils.cpp at master · RadeonOpenCompute/ROCm-OpenCL-Runtime». github.com. 3 de maio de 2017. Consultado em 24 de abril de 2025. Cópia arquivada em 25 de dezembro de 2018
- ↑ «The AMD Radeon RX Vega 64 & RX Vega 56 Review: Vega Burning Bright». Anandtech.com. 14 de agosto de 2017. Consultado em 24 de abril de 2025
- ↑ «AMD's Vega Mobile Lives: Vega Pro 20 & 16 in Updated MacBook Pros In November». Anandtech.com. 30 de outubro de 2018. Consultado em 24 de abril de 2025
- ↑ «AMD Announces Radeon Instinct MI60 & MI50 Accelerators: Powered By 7nm Vega». Anandtech.com. 6 de novembro de 2018. Consultado em 24 de abril de 2025
- ↑ Ferreira, Bruno (16 de maio de 2017). «Ryzen Mobile APUs are coming to a laptop near you». Tech Report. Consultado em 24 de abril de 2025. Cópia arquivada em 25 de outubro de 2018
- ↑ «AMD Unveils World's First 7nm Datacenter GPUs – Powering the Next Era of Artificial Intelligence, Cloud Computing and High Performance Computing (HPC) | AMD». AMD.com (Nota de imprensa). 6 de novembro de 2018. Consultado em 24 de abril de 2025. Cópia arquivada em 10 de novembro de 2018
- ↑ «RadeonFeature». x.Org. Consultado em 24 de abril de 2025
- ↑ «AMD Tahiti GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Pitcairn GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Cape Verde GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Oland GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Hainan GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Bonaire GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Hawaii GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Topaz GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Tonga GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Fiji GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Ellesmere GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Baffin GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Lexa GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Vega 10 GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Vega 12 GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025
- ↑ «AMD Vega 20 GPU Specs». TechPowerUp. Consultado em 25 de abril de 2025