Unidade de Processamento Tensorial
Tensor Processing Unit | |
|---|---|
 | |
| Data de lançamento | 2015 |
| Codinome(s) | TPU |
| Fabricante | |
| NPU, ASIC | |
| Modelos | |
| Versões dos drivers | |
| Cronologia | |
Tensor Processing Unit (TPU) é uma unidade de processamento neural (NPU) e circuito integrado de aplicação específica (ASIC) desenvolvido pela Google para redes neurais e aprendizado de máquina. Os frameworks compatíveis com TPU são TensorFlow, JAX e PyTorch. A Google começou a usar TPUs internamente em 2015 e, em 2018, tornou-as disponíveis para uso de terceiros, tanto como parte de sua infraestrutura de nuvem quanto oferecendo uma versão menor do chip para venda.
Comparação entre TPUs e GPUs
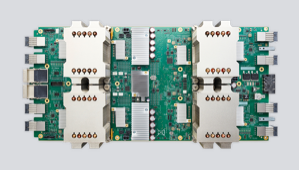
Em comparação com uma unidade de processamento gráfico (GPU), as TPUs são projetadas para um grande volume de computação de baixa precisão (por exemplo, tão baixa quanto 8 bits) com mais operações de entrada/saída por joule, sem hardware para rasterização ou mapeamento de textura. Os ASICs TPU são montados em um conjunto de dissipadores de calor que pode ser encaixado em um compartimento de disco rígido dentro de um rack de datacenter, de acordo com Norman Jouppi.
Diferentes tipos de processadores são adequados para diferentes tipos de modelos de aprendizado de máquina. As TPUs são bem adequadas para redes neurais convolucionais (CNNs), enquanto as GPUs têm benefícios para algumas redes neurais totalmente conectadas, e as CPUs podem ter vantagens para redes neurais recorrentes (RNNs).
História
Em 2013, a Google recrutou Amir Salek para estabelecer capacidades de desenvolvimento de silício personalizado para os datacenters da empresa. Como fundador e chefe de Silício Personalizado para a Infraestrutura Técnica da Google e Google Cloud, Salek liderou o desenvolvimento do TPU original (o primeiro chip de produção da Google), TPUv2 (o primeiro chip de treinamento de deep learning de produção do setor), TPUv3, TPUv4, Edge-TPU e produtos de silício adicionais, incluindo VCU, IPU e OpenTitan. De acordo com Jonathan Ross, um dos engenheiros originais do TPU, e mais tarde fundador da Groq, três grupos separados na Google estavam desenvolvendo aceleradores de IA, sendo o TPU, um arranjo sistólico, o projeto que foi finalmente selecionado.
Norman P. Jouppi atuou como líder técnico e arquiteto principal do desenvolvimento da Tensor Processing Unit da Google, liderando o rápido projeto, verificação e implantação do primeiro TPU em produção em apenas 15 meses. Como autor principal do artigo seminal de 2017 "In-Datacenter Performance Analysis of a Tensor Processing Unit", apresentado no 44º International Symposium on Computer Architecture (ISCA 2017), Jouppi demonstrou que o TPU atingia desempenho 15–30 vezes maior e eficiência energética 30–80 vezes maior do que CPUs e GPUs contemporâneas, estabelecendo o TPU como uma plataforma fundamental para inferência de redes neurais em escala nos serviços de produção da Google.
A tensor processing unit foi anunciada em maio de 2016 na conferência Google I/O, quando a empresa afirmou que o TPU estava sendo usado dentro de seus datacenters há mais de um ano. O artigo de 2017 da Google que descreve sua criação cita multiplicadores de matrizes sistólicas de arquitetura semelhante construídos na década de 1990. O chip foi projetado especificamente para o framework TensorFlow da Google, uma biblioteca matemática simbólica usada para aplicações de aprendizado de máquina, como redes neurais. No entanto, a partir de 2017, a Google ainda usava CPUs e GPUs para outros tipos de aprendizado de máquina. Outros designs de acelerador de IA estão surgindo de outros fornecedores também e visam os mercados embarcado e de robótica.
As TPUs da Google são proprietárias. Alguns modelos estão disponíveis comercialmente e, em 12 de fevereiro de 2018, o The New York Times informou que a Google "permitiria que outras empresas comprassem acesso a esses chips através de seu serviço de computação em nuvem". A Google afirmou que eles foram usados na série de partidas de Go AlphaGo versus Lee Sedol (humano versus máquina), bem como no sistema AlphaZero, que produziu programas de jogo de Xadrez, Shogi e Go apenas a partir das regras do jogo e depois venceu os programas líderes nesses jogos. A Google também usou TPUs para processamento de texto do Google Street View e foi capaz de encontrar todo o texto na base de dados do Street View em menos de cinco dias. No Google Fotos, uma única TPU pode processar mais de 100 milhões de fotos por dia. Também é usada no RankBrain, que a Google usa para fornecer resultados de pesquisa.
A Google fornece a terceiros acesso às TPUs através do serviço Cloud TPU como parte do Google Cloud Platform e através de seus serviços baseados em notebooks Kaggle e Colaboratory.
A Broadcom é co-desenvolvedora das TPUs, traduzindo a arquitetura e especificações da Google em silício fabricável. Ela fornece tecnologias proprietárias, como interfaces de alta velocidade SerDes, supervisiona o design ASIC e gerencia a fabricação e embalagem dos chips através de fundições terceirizadas como a Taiwan Semiconductor Manufacturing Company (TSMC), abrangendo todas as gerações desde o início do programa.
Em setembro de 2025, a Google está em negociações com várias "neoclouds", incluindo Crusoe e CoreWeave, sobre a implantação de TPU em seus datacenters. Em novembro de 2025, a Meta está em negociações com a Google para implantar TPUs em seus datacenters de IA.
Produtos
| v1 | v2 | v3 | v4 | v5e | v5p | v6e (Trillium) | v7 (Ironwood) | v8t / v8i | |
|---|---|---|---|---|---|---|---|---|---|
| Data de introdução | 2015 | 2017 | 2018 | 2021 | 2023 | 2023 | 2024 | 2025 | 2026 |
| Nó de processo | 28 nm | 16 nm | 16 nm | 7 nm | Não listado | Não listado | Não listado | Não listado | Não listado |
| Tamanho do die (mm2) | 331 | < 625 | < 700 | < 400 | 300–350 | Não listado | Não listado | Não listado | Não listado |
| Memória no chip (MiB) | 28 | 32 | 32 (VMEM) + 5 (spMEM) | 128 (CMEM) + 32 (VMEM) + 10 (spMEM) | Não listado | Não listado | Não listado | Não listado | 384 (v8i) |
| Velocidade do clock (MHz) | 700 | 700 | 940 | 1050 | Não listado | 1750 | Não listado | Não listado | Não listado |
| Memória | 8 GiB DDR3 | 16 GiB HBM | 32 GiB HBM | 32 GiB HBM | 16 GB HBM | 95 GB HBM | 32 GB | 192 GB HBM | 216/288 GB HBM3e |
| Largura de banda da memória | 34 GB/s | 600 GB/s | 900 GB/s | 1200 GB/s | 819 GB/s | 2765 GB/s | 1640 GB/s | 7,37 TB/s | 6,5/8,6 TB/s |
| Potência térmica de projeto (W) | 75 | 280 | 220 | 170 | Não listado | Não listado | Não listado | Não listado | Não listado |
| Desempenho computacional (trilhões de operações por segundo) | 23 | 45 | 123 | 275 | 197 (bf16) 393 (int8) | 459 (bf16) 918 (int8) | 918 (bf16) 1836 (int8) | 4614 (fp8) | 12600 (v8t fp4) 10100 (v8i fp4) |
| Eficiência energética (teraOPS/W) | 0.31 | 0.16 | 0.56 | 1.62 | Não listado | Não listado | Não listado | 4,7 | Não listado |
Primeira geração TPU
A TPU de primeira geração é um mecanismo de multiplicação de matrizes de 8 bits, controlado por instruções CISC do processador hospedeiro através de um barramento PCIe 3.0. É fabricada em um processo de 28 nm com um tamanho de die ≤ 331 mm2. A velocidade do clock é de 700 MHz e tem uma potência térmica de projeto de 28–40 W. Possui 28 MiB de memória no chip e 4 MiB de acumuladores de 32 bits que recebem os resultados de um arranjo sistólico 256×256 de multiplicadores de 8 bits. Dentro do pacote TPU há 8 GiB de DDR3 SDRAM de 2133 MHz em dual-channel oferecendo 34 GB/s de largura de banda. As instruções transferem dados para ou do hospedeiro, realizam multiplicações de matrizes ou convoluções e aplicam funções de ativação.
Segunda geração TPU
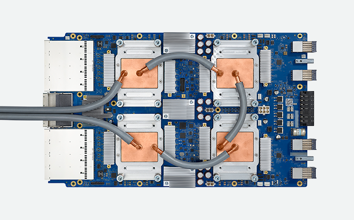
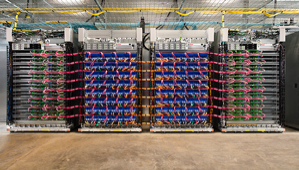
A TPU de segunda geração foi anunciada em maio de 2017. A Google declarou que o design da TPU de primeira geração era limitado pela largura de banda da memória e que usar 16 GB de High Bandwidth Memory no design de segunda geração aumentou a largura de banda para 600 GB/s e o desempenho para 45 teraFLOPS. As TPUs são então organizadas em módulos de quatro chips com um desempenho de 180 teraFLOPS. Em seguida, 64 desses módulos são montados em pods de 256 chips com 11,5 petaFLOPS de desempenho. Notavelmente, enquanto as TPUs de primeira geração eram limitadas a inteiros, as TPUs de segunda geração também podem calcular em ponto flutuante, introduzindo o formato bfloat16 inventado pelo Google Brain. Isso torna as TPUs de segunda geração úteis tanto para treinamento quanto para inferência de modelos de aprendizado de máquina. A Google afirmou que essas TPUs de segunda geração estarão disponíveis no Google Compute Engine para uso em aplicações TensorFlow.
Terceira geração TPU
A TPU de terceira geração foi anunciada em 8 de maio de 2018. A Google anunciou que os próprios processadores são duas vezes mais potentes que as TPUs de segunda geração e seriam implantados em pods com quatro vezes mais chips que a geração anterior. Isso resulta em um aumento de 8 vezes no desempenho por pod (com até 1.024 chips por pod) em comparação com a implantação da TPU de segunda geração.
Quarta geração TPU

Em 18 de maio de 2021, o CEO da Google, Sundar Pichai, falou sobre as Tensor Processing Units TPU v4 durante seu discurso principal na conferência virtual Google I/O. A TPU v4 melhorou o desempenho em mais de 2 vezes em relação aos chips TPU v3. Pichai disse: "Um único pod v4 contém 4.096 chips v4, e cada pod tem 10 vezes a largura de banda de interconexão por chip em escala, em comparação com qualquer outra tecnologia de rede." Um artigo de abril de 2023 da Google afirma que a TPU v4 é de 5 a 87% mais rápida que uma Nvidia A100 em benchmarks de aprendizado de máquina.
Há também uma versão de "inferência", chamada v4i, que não requer resfriamento líquido.
Quinta geração TPU
Em 2021, a Google revelou que o layout físico da TPU v5 está sendo projetado com a assistência de uma nova aplicação de aprendizado por reforço profundo. A Google afirma que a TPU v5 é quase duas vezes mais rápida que a TPU v4, e com base nisso e no desempenho relativo da TPU v4 sobre a A100, alguns especulam que a TPU v5 é tão rápida quanto ou mais rápida que uma H100.
Semelhante à v4i ser uma versão mais leve da v4, a quinta geração tem uma versão "econômica" chamada v5e. Em dezembro de 2023, a Google anunciou a TPU v5p, que afirma ser competitiva com a Nvidia H100.
Sexta geração TPU
Em maio de 2024, na conferência Google I/O, a Google anunciou o Trillium, que ficou disponível em pré-visualização em outubro de 2024. A Google afirmou um aumento de desempenho de 4,7 vezes em relação à TPU v5e, através de unidades de multiplicação de matrizes maiores e uma velocidade de clock aumentada. A capacidade e a largura de banda da memória de alta largura de banda (HBM) também dobraram. Um pod pode conter até 256 unidades Trillium.
Sétima geração TPU
Em abril de 2025, na conferência Google Cloud Next, a Google apresentou a TPU v7. Este novo chip, chamado Ironwood, virá em duas configurações: um cluster de 256 chips e um cluster de 9.216 chips. O Ironwood terá uma taxa de desempenho computacional de pico de 4.614 TFLOP/s.
Oitava geração TPU
Em 22 de abril de 2026, a Google anunciou a oitava geração de suas Tensor Processing Units, consistindo de dois chips especializados: o TPU 8t e o TPU 8i. Esta é a primeira vez que a Google divide sua arquitetura TPU em designs separados otimizados para treinamento e inferência. Ambos os chips são hospedados em CPUs customizadas da Google baseadas em Arm, chamadas Axion, e utilizam resfriamento líquido de quarta geração.
TPU 8t
A TPU 8t ("Training") é otimizada para pré-treinamento em larga escala de modelos de ponta e cargas de trabalho pesadas de embeddings. Ela entrega 12,6 FP4 PFLOPs de desempenho de pico e possui 216 GB de memória HBM3e com largura de banda de 6.528 GB/s. Utiliza a malha de rede Virgo, permitindo escalar até 9.600 chips por "superpod", entregando 121 FP4 ExaFLOPs de desempenho computacional.
TPU 8i
A TPU 8i ("Inference") é projetada para inferência de alta velocidade, agentes de IA e raciocínio de longo contexto. Ela entrega 10,1 FP4 PFLOPs de desempenho de pico e possui 288 GB de memória HBM3e com largura de banda de 8.601 GB/s. Inclui 384 MB de SRAM no chip, um aumento de três vezes em relação à geração anterior. A TPU 8i introduz uma topologia de rede "Boardfly" e um mecanismo de aceleração de coletivos (CAE) que reduz a latência de sincronização em cinco vezes.
Edge TPU
Em julho de 2018, a Google anunciou a Edge TPU. A Edge TPU é um chip ASIC projetado especificamente pela Google para executar modelos de aprendizado de máquina para computação de borda, o que significa que é muito menor e consome muito menos energia em comparação com as TPUs hospedadas nos datacenters da Google (também conhecidas como Cloud TPUs). Em janeiro de 2019, a Google disponibilizou a Edge TPU para desenvolvedores com uma linha de produtos sob a marca Coral. A Edge TPU é capaz de realizar 4 trilhões de operações por segundo com 2 W de energia elétrica.
As ofertas de produtos incluem um computador de placa única (SBC), um sistema em módulo (SoM), um acessório USB, uma placa PCI-e mini e uma placa M.2. O Coral Dev Board (SBC) e o Coral SoM executam o sistema operacional Mendel Linux – um derivado do Debian. Os produtos USB, PCI-e e M.2 funcionam como complementos para sistemas de computador existentes e suportam sistemas Linux baseados em Debian em hosts x86-64 e ARM64 (incluindo Raspberry Pi).
O runtime de aprendizado de máquina usado para executar modelos na Edge TPU é baseado no TensorFlow Lite. A Edge TPU só é capaz de acelerar operações de passagem direta, o que significa que é útil principalmente para realizar inferências (embora seja possível realizar aprendizado por transferência leve na Edge TPU). A Edge TPU também suporta apenas matemática de 8 bits, o que significa que, para uma rede ser compatível com a Edge TPU, ela precisa ser treinada usando a técnica de treinamento com quantização consciente do TensorFlow ou, desde o final de 2019, também é possível usar quantização pós-treinamento.
Em 12 de novembro de 2019, a Asus anunciou um par de computadores de placa única (SBCs) com a Edge TPU. As placas Asus Tinker Edge T e Tinker Edge R são projetadas para IoT e IA de borda. Os SBCs suportam oficialmente os sistemas operacionais Android e Debian. A ASUS também demonstrou um mini PC chamado Asus PN60T com a Edge TPU.
Em 2 de janeiro de 2020, a Google anunciou o Coral Accelerator Module e o Coral Dev Board Mini, a serem demonstrados na CES 2020 no final do mesmo mês. O Coral Accelerator Module é um módulo multi-chip com a Edge TPU e interfaces PCIe e USB para facilitar a integração. O Coral Dev Board Mini é um computador de placa única (SBC) menor com o Coral Accelerator Module e o SoC MediaTek 8167s.
Pixel Neural Core
Em 15 de outubro de 2019, a Google anunciou o Pixel 4 smartphone, que contém uma Edge TPU chamada Pixel Neural Core. A Google descreveu-a como "customizada para atender aos requisitos dos principais recursos de câmera no Pixel 4", usando uma busca de rede neural que sacrifica alguma precisão em favor de minimizar a latência e o consumo de energia.
Google Tensor
A Google seguiu o Pixel Neural Core integrando uma Edge TPU em um sistema em chip personalizado chamado Google Tensor, que foi lançado em 2021 com a linha de smartphones Pixel 6. O SoC Google Tensor demonstrou "vantagens de desempenho extremamente grandes sobre a concorrência" em benchmarks focados em aprendizado de máquina; embora o consumo instantâneo de energia também fosse relativamente alto, o desempenho melhorado significava que menos energia era consumida devido a períodos mais curtos exigindo desempenho máximo.
Processo judicial
Em 2019, a Singular Computing, fundada em 2009 por Joseph Bates, um professor visitante no MIT, entrou com uma ação contra a Google alegando infração de patente nos chips TPU. Em 2020, a Google conseguiu reduzir o número de reivindicações que o tribunal consideraria para apenas duas: a reivindicação 53 da patente US:8407273 depositada em 2012 e a reivindicação 7 da patente US:9218156 depositada em 2013, ambas reivindicando uma faixa dinâmica de 10−6 a 106 para números de ponto flutuante, o que o formato float16 padrão não consegue fazer (sem recorrer a números subnormais) pois possui apenas cinco bits para o expoente. Em um documento judicial de 2023, a Singular Computing destacou especificamente o uso do bfloat16 pela Google, pois isso excede a faixa dinâmica do float16. A Singular Computing afirma que os formatos de ponto flutuante não padrão eram não óbvios em 2009, mas a Google replica que o formato VFLOAT, com um número configurável de bits de expoente, existia como estado da técnica em 2002. Em janeiro de 2024, processos subsequentes da Singular Computing elevaram o número de patentes em litígio para oito. No final do julgamento no mesmo mês, a Google concordou com um acordo em termos não divulgados.
Ver também
- Acelerador de IA
- Datacenter de IA
- Computador cognitivo
- Google Colab – Python IDE online que pode utilizar TPUs via nuvem
- Tensor Core – arquitetura semelhante da Nvidia
- TrueNorth – dispositivo semelhante que simula neurônios de disparo em vez de tensores de baixa precisão
- Unidade de processamento de visão – dispositivo semelhante especializado em processamento de visão
Referências
- 1 2 Norman P. Jouppi; Cliff Young; et al. (2017). In-Datacenter Performance Analysis of a Tensor Processing Unit. International Symposium on Computer Architecture. Toronto, Canadá: Association for Computing Machinery. pp. 1–12. arXiv:1704.04760
 . doi:10.1145/3079856.3080246. Cópia arquivada em 21 de janeiro de 2025
- ↑ «Cloud Tensor Processing Units (TPUs)». Google Cloud. Consultado em 10 de dezembro de 2025
- ↑ «TPU software versions». Google Cloud Documentation (em inglês). Consultado em 10 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Armasu, Lucian (19 de maio de 2016). «Google's Big Chip Unveil For Machine Learning: Tensor Processing Unit With 10x Better Efficiency (Updated)». Tom's Hardware. Consultado em 26 de junho de 2016
- 1 2 3 Jouppi, Norm (18 de maio de 2016). «Google supercharges machine learning tasks with TPU custom chip». Google Cloud Platform Blog (em inglês). Consultado em 22 de janeiro de 2017. Cópia arquivada em 18 de maio de 2016
- 1 2 3 4 «Google's Tensor Processing Unit explained: this is what the future of computing looks like». TechRadar (em inglês). Consultado em 19 de janeiro de 2017. Cópia arquivada em 26 de fevereiro de 2022
- ↑ Wang, Yu Emma; Wei, Gu-Yeon; Brooks, David (1 de julho de 2019). «Benchmarking TPU, GPU, and CPU Platforms for Deep Learning». arXiv:1907.10701 [cs.LG]
- ↑ «Amir Salek». Avicena. Consultado em 16 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Kynge, James (3 de dezembro de 2024). «Transcript: The geopolitics of chips — Nvidia and the AI boom». Financial Times. Consultado em 16 de dezembro de 2025. Cópia arquivada em 11 de dezembro de 2025
- ↑ Cerberus Capital Management. «Amir Salek – Leadership». Cerberus Capital Management. Consultado em 16 de dezembro de 2025
- ↑ Ross, Jonathan. «Publicação de Jonathan Ross». LinkedIn
- ↑ Sato, Kaz (18 de junho de 2018). «An in-depth look at Google's first Tensor Processing Unit (TPU)». Google Cloud Blog. Consultado em 16 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Jouppi, Norman P. (15 de abril de 2017). «In-Datacenter Performance Analysis of a Tensor Processing Unit». arXiv:1704.04760 [cs.AR]
- ↑ «Norm Jouppi - VP, Engineering Fellow - AI and Infrastructure». Google Technical Systems Infrastructure. Consultado em 16 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- 1 2 3
Jouppi, Norman P.; Young, Cliff; Patil, Nishant; Patterson, David; Agrawal, Gaurav; Bajwa, Raminder; Bates, Sarah; Bhatia, Suresh; Boden, Nan; Borchers, Al; Boyle, Rick; Cantin, Pierre-luc; Chao, Clifford; Clark, Chris; Coriell, Jeremy; Daley, Mike; Dau, Matt; Dean, Jeffrey; Gelb, Ben; Ghaemmaghami, Tara Vazir; Gottipati, Rajendra; Gulland, William; Hagmann, Robert; Ho, C. Richard; Hogberg, Doug; Hu, John; Hundt, Robert; Hurt, Dan; Ibarz, Julian; Jaffey, Aaron; Jaworski, Alek; Kaplan, Alexander; Khaitan, Harshit; Koch, Andy; Kumar, Naveen; Lacy, Steve; Laudon, James; Law, James; Le, Diemthu; Leary, Chris; Liu, Zhuyuan; Lucke, Kyle; Lundin, Alan; MacKean, Gordon; Maggiore, Adriana; Mahony, Maire; Miller, Kieran; Nagarajan, Rahul; Narayanaswami, Ravi; Ni, Ray; Nix, Kathy; Norrie, Thomas; Omernick, Mark; Penukonda, Narayana; Phelps, Andy; Ross, Jonathan; Ross, Matt; Salek, Amir; Samadiani, Emad; Severn, Chris; Sizikov, Gregory; Snelham, Matthew; Souter, Jed; Steinberg, Dan; Swing, Andy; Tan, Mercedes; Thorson, Gregory; Tian, Bo; Toma, Horia; Tuttle, Erick; Vasudevan, Vijay; Walter, Richard; Wang, Walter; Wilcox, Eric; Yoon, Doe Hyun (26 de junho de 2017). In-Datacenter Performance Analysis of a Tensor Processing Unit™. Toronto, Canadá. arXiv:1704.04760
- ↑ "TensorFlow: Open source machine learning" Arquivado em 2016-12-15 no Wayback Machine "É um software de aprendizado de máquina usado para vários tipos de tarefas de percepção e compreensão de linguagem" — Jeffrey Dean, minuto 0:47 / 2:17 do clipe do Youtube
- ↑ Metz, Cade (12 de fevereiro de 2018). «Google Makes Its Special A.I. Chips Available to Others». The New York Times (em inglês). Consultado em 12 de fevereiro de 2018. Cópia arquivada em 8 de abril de 2022
- ↑ McGourty, Colin (6 de dezembro de 2017). «DeepMind's AlphaZero crushes chess». chess24.com (em inglês). Consultado em 12 de dezembro de 2017. Cópia arquivada em 12 de dezembro de 2018
- ↑ «Google's Tensor Processing Unit could advance Moore's Law 7 years into the future». PCWorld (em inglês). Consultado em 19 de janeiro de 2017. Cópia arquivada em 18 de fevereiro de 2019
- ↑ «Frequently Asked Questions | Cloud TPU». Google Cloud (em inglês). Consultado em 14 de janeiro de 2021. Cópia arquivada em 15 de agosto de 2025
- ↑ «Google Colaboratory». colab.research.google.com (em inglês). Consultado em 15 de maio de 2021
- ↑ «Use TPUs | TensorFlow Core». TensorFlow (em inglês). Consultado em 15 de maio de 2021
- ↑ Tarasov, Katie (23 de agosto de 2024). «How Google makes custom chips used to train Apple AI models and its own chatbot, Gemini». CNBC (em inglês). Consultado em 19 de setembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Gallagher, Dan (25 de setembro de 2023). «Broadcom's AI Business Won't Be Easy to Chip Away». The Wall Street Journal (em inglês). Consultado em 19 de setembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Mann, Tobias (23 de setembro de 2023). «FYI: Those fancy 'Google-designed' TPU AI chips had an awful lot of Broadcom help». The Register. Cópia arquivada em 13 de dezembro de 2025
- ↑ say, Georgia Butler (8 de setembro de 2025). «Google offers its TPUs to AI cloud providers - report». www.datacenterdynamics.com (em inglês). Consultado em 10 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ «Google Ramps Up AI Chip Competition with Nvidia». The Information (em inglês). Consultado em 10 de dezembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Jouppi, Norman P.; Yoon, Doe Hyun; Ashcraft, Matthew; Gottscho, Mark (14 de junho de 2021). Ten lessons from three generations that shaped Google's TPUv4i (PDF). International Symposium on Computer Architecture. Valência, Espanha. ISBN 978-1-4503-9086-6. doi:10.1109/ISCA52012.2021.00010. Consultado em 18 de junho de 2021. Arquivado do original (PDF) em 9 de junho de 2021
- 1 2 «System Architecture | Cloud TPU». Google Cloud (em inglês). Consultado em 11 de dezembro de 2022. Cópia arquivada em 11 de dezembro de 2022
- 1 2 3 Kennedy, Patrick (22 de agosto de 2017). «Case Study on the Google TPU and GDDR5 from Hot Chips 29». Serve The Home. Consultado em 23 de agosto de 2017. Cópia arquivada em 23 de novembro de 2021
- ↑ Fique ligado, mais informações sobre TPU v4 em breve Arquivado em 2023-03-12 no Wayback Machine, recuperado em 2020-08-06.
- ↑ Jouppi, Norman P.; Kurian, George; Li, Sheng; Ma, Peter; Nagarajan, Rahul; Nai, Lifeng; Patil, Nishant; Subramanian, Suvinay; Swing, Andy; Towles, Brian; Young, Cliff; Zhou, Xiang; Zhou, Zongwei; Patterson, David (2023). «TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings». arXiv:2304.01433 [cs.AR]
- 1 2 Cloud TPU v5e Inference Public Preview, recuperado em 2023-11-06.
- ↑ Cloud TPU v5p Arquivado em 2025-04-28 no Wayback Machine Google Cloud. recuperado em 2024-04-09
- ↑ Cloud TPU v5p Training Arquivado em 2025-02-11 no Wayback Machine, recuperado em 2024-04-09.
- ↑ «Introducing Trillium, sixth-generation TPUs». Google Cloud Blog (em inglês). Consultado em 29 de maio de 2024. Cópia arquivada em 8 de junho de 2026
- ↑ «TPU v6e». Google Cloud (em inglês). Consultado em 10 de novembro de 2024. Cópia arquivada em 10 de maio de 2025
- 1 2 3 4 «Google Cloud introduces TPU 8t and 8i for the agentic era». Google Cloud Blog. Consultado em 29 de abril de 2026. Cópia arquivada em 8 de junho de 2026
- ↑ «Ironwood: The first Google TPU for the age of inference». Google Blog (em inglês). 9 de abril de 2025. Consultado em 9 de abril de 2025. Cópia arquivada em 3 de maio de 2025
- 1 2 3 Bright, Peter (17 de maio de 2017). «Google brings 45 teraflops tensor flow processors to its compute cloud». Ars Technica. Consultado em 30 de maio de 2017. Cópia arquivada em 6 de março de 2022
- ↑ Kennedy, Patrick (17 de maio de 2017). «Google Cloud TPU Details Revealed». Serve The Home. Consultado em 30 de maio de 2017. Cópia arquivada em 12 de junho de 2022
- ↑ Frumusanu, Andre (8 de maio de 2018). «Google I/O Opening Keynote Live-Blog». Consultado em 9 de maio de 2018. Arquivado do original em 8 de maio de 2018
- ↑ Feldman, Michael (11 de maio de 2018). «Google Offers Glimpse of Third-Generation TPU Processor». Top 500. Consultado em 14 de maio de 2018. Cópia arquivada em 18 de novembro de 2021
- ↑ Teich, Paul (10 de maio de 2018). «Tearing Apart Google's TPU 3.0 AI Coprocessor». The Next Platform. Consultado em 14 de maio de 2018. Cópia arquivada em 15 de maio de 2022
- ↑ «Google Launches TPU v4 AI Chips». www.hpcwire.com. 20 de maio de 2021. Consultado em 7 de junho de 2021. Cópia arquivada em 7 de junho de 2021
- ↑ Jouppi, Norman (20 de abril de 2023). «TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings». arXiv:2304.01433 [cs.AR]
- ↑ Kennedy, Patrick (29 de agosto de 2023). «Google Details TPUv4 and its Crazy Optically Reconfigurable AI Network». servethehome.com. Consultado em 16 de dezembro de 2023. Cópia arquivada em 8 de junho de 2026
- ↑ «Why did Google develop its own TPU chip? In-depth disclosure of team members». censtry.com. 20 de outubro de 2021. Consultado em 16 de dezembro de 2023. Cópia arquivada em 8 de junho de 2026
- ↑ Mirhoseini, Azalia; Goldie, Anna (1 de junho de 2021). «A graph placement methodology for fast chip design» (PDF). Nature. 594 (7962): 207–212. PMID 35361999. doi:10.1038/s41586-022-04657-6. Consultado em 4 de junho de 2023. Arquivado do original (PDF) em 6 de agosto de 2024
- ↑ Vahdat, Amin (6 de dezembro de 2023). «Enabling next-generation AI workloads: Announcing TPU v5p and AI Hypercomputer». Consultado em 8 de abril de 2024. Cópia arquivada em 7 de abril de 2024
- ↑ Afifi-Sabet, Keumars (23 de dezembro de 2023). «Google is rapidly turning into a formidable opponent to BFF Nvidia — the TPU v5p AI chip powering its hypercomputer is faster and has more memory and bandwidth than ever before, beating even the mighty H100». TechRadar. Consultado em 8 de abril de 2024. Cópia arquivada em 11 de fevereiro de 2025
- ↑ «Expanding our AI-optimized infrastructure portfolio: Introducing Cloud TPU v5e and announcing A3 GA». 29 de agosto de 2023. Consultado em 16 de dezembro de 2023. Cópia arquivada em 20 de setembro de 2023
- ↑ «Enabling next-generation AI workloads: Announcing TPU v5p and AI Hypercomputer». 6 de dezembro de 2023. Consultado em 9 de abril de 2024. Cópia arquivada em 8 de junho de 2026
- ↑ Lohmeyer, Mark (30 de outubro de 2024). «Powerful infrastructure innovations for your AI-first future»
- ↑ Velasco, Alan (15 de maio de 2024). «Google Cloud Unveils Trillium, Its 6th-Gen TPU With A 4.7X AI Performance Leap». HotHardware. HotHardware. Consultado em 15 de maio de 2024
- ↑ «Introducing Trillium, sixth-generation TPUs». Google Cloud Blog (em inglês). Consultado em 17 de maio de 2024. Cópia arquivada em 8 de junho de 2026
- ↑ «The Silicon Valley 'AI factory' at the heart of the tech race». www.bbc.com. 19 de novembro de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ Wiggers, Kyle (9 de abril de 2025). «Ironwood is Google's newest AI accelerator chip». TechCrunch (em inglês). Consultado em 10 de abril de 2025. Cópia arquivada em 8 de junho de 2026
- ↑ «Google's Eighth-Gen TPUs: TPU 8t and TPU 8i». Tom's Hardware. Consultado em 29 de abril de 2026
- ↑ «Cloud TPU». Google Cloud (em inglês). Consultado em 21 de maio de 2021. Cópia arquivada em 6 de maio de 2025
- ↑ «Edge TPU performance benchmarks». Coral (em inglês). Consultado em 4 de janeiro de 2020
- ↑ «Dev Board». Coral (em inglês). Consultado em 21 de maio de 2021. Cópia arquivada em 20 de maio de 2026
- ↑ «System-on-Module (SoM)». Coral (em inglês). Consultado em 21 de maio de 2021. Cópia arquivada em 20 de maio de 2026
- ↑ «Bringing intelligence to the edge with Cloud IoT». Google Blog (em inglês). 25 de julho de 2018. Consultado em 25 de julho de 2018
- ↑ «Retrain an image classification model on-device». Coral. Consultado em 3 de maio de 2019
- ↑ «組込み総合技術展&IoT総合技術展「ET & IoT Technology 2019」に出展することを発表». Asus.com (em japonês). Consultado em 13 de novembro de 2019. Cópia arquivada em 8 de junho de 2026
- ↑ Shilov, Anton. «ASUS & Google Team Up for 'Tinker Board' AI-Focused Credit-Card Sized Computers». Anandtech.com. Consultado em 13 de novembro de 2019. Arquivado do original em 13 de novembro de 2019
- ↑ Aufranc, Jean-Luc (29 de maio de 2019). «ASUS Tinker Edge T & CR1S-CM-A SBC to Feature Google Coral Edge TPU & NXP i.MX 8M Processor». CNX Software – Embedded Systems News (em inglês). Consultado em 14 de novembro de 2019
- ↑ «New Coral products for 2020». Google Developers Blog (em inglês). Consultado em 4 de janeiro de 2020. Cópia arquivada em 22 de fevereiro de 2024
- ↑ «Accelerator Module». Coral (em inglês). Consultado em 4 de janeiro de 2020. Cópia arquivada em 22 de maio de 2026
- ↑ «Introducing the Next Generation of On-Device Vision Models: MobileNetV3 and MobileNetEdgeTPU». Google AI Blog (em inglês). Consultado em 16 de abril de 2020. Cópia arquivada em 2 de maio de 2023
- ↑ Gupta, Suyog; White, Marie (8 de novembro de 2021). «Improved On-Device ML on Pixel 6, with Neural Architecture Search». Google AI Blog. Consultado em 16 de dezembro de 2022. Cópia arquivada em 4 de maio de 2023
- ↑ Frumusanu, Andrei (2 de novembro de 2021). «Google's Tensor inside of Pixel 6, Pixel 6 Pro: A Look into Performance & Efficiency | Google's IP: Tensor TPU/NPU». AnandTech. Consultado em 16 de dezembro de 2022. Arquivado do original em 3 de novembro de 2021
- ↑ Hardesty, Larry (3 de janeiro de 2011). «The surprising usefulness of sloppy arithmetic». MIT. Consultado em 10 de janeiro de 2024. Cópia arquivada em 8 de junho de 2026
- ↑ Bray, Hiawatha (10 de janeiro de 2024). «Local inventor challenges Google in billion-dollar patent fight». Boston Globe. Boston. Consultado em 10 de janeiro de 2024. Cópia arquivada em 10 de janeiro de 2024
- ↑ «SINGULAR COMPUTING LLC, Plaintiff, v. GOOGLE LLC, Defendant: Amended Complaint for Patent Infringement» (PDF). rpxcorp.com. RPX Corporation. 20 de março de 2020. Consultado em 10 de janeiro de 2024. Cópia arquivada (PDF) em 8 de junho de 2026
- ↑ Wang, Xiaojun; Leeser, Miriam (1 de setembro de 2010). «VFloat: A Variable Precision Fixed- and Floating-Point Library for Reconfigurable Hardware»
 . ACM Transactions on Reconfigurable Technology and Systems. 3 (3): 1–34. doi:10.1145/1839480.1839486. Consultado em 10 de janeiro de 2024. Cópia arquivada em 30 de abril de 2024
- ↑ «Singular Computing LLC v. Google LLC». casetext.com. 6 de abril de 2023. Consultado em 10 de janeiro de 2024. Arquivado do original em 26 de setembro de 2023
- ↑ Calkins, Laurel Brubaker (24 de janeiro de 2024). «Google Settles AI-Chip Suit That Had Sought Over $5 Billion». Bloomberg Law. Cópia arquivada em 8 de junho de 2026
- ↑ Brittain, Blake; Raymond, Ray (24 de janeiro de 2024). «Google settles AI-related chip patent lawsuit that sought $1.67 bln». Reuters. Cópia arquivada em 25 de abril de 2025
Ligações externas
- Cloud Tensor Processing Units (TPUs) (Documentação do Google Cloud)
- Foto do chip e placa TPU da Google
- Foto da placa TPU v2 da Google. Arquivado em 2021-08-09 no Wayback Machine
- Foto da placa TPU v3 da Google. Arquivado em 2021-03-08 no Wayback Machine
- Foto do pod TPU v2 da Google. Arquivado em 2021-08-09 no Wayback Machine